Рабочий проект · Telegram → MAX
re-publisher
Беру новые сообщения из Telegram-папки MAX. На сервере пост проходит классификацию, фильтры и добавление источника. Подходящие материалы уходят в каналы MAX с исходным текстом и вложениями. В рабочем интерфейсе видны оценки моделей, OCR, лейблы, ошибки и история отправки.
Обзор: стадии, живые циклы служб, очереди моделей и ошибки медиа. Снимок рабочего сервиса, 3 октября 2026.
01 / Задача
Посты из Telegram в тематические каналы MAX
Хотел разбирать поток из нескольких каналов без ручного переноса каждого поста. Собрал конвейер, где можно посмотреть, почему материал отобран, что прочитал OCR и куда он отправился.
Сценарий: Моя рабочая область для тематических подборок. Публичный результат — каналы MAX; административный интерфейс закрыт паролем.
Что делал
- Сбор новых сообщений через Telethon, сохранение оригиналов, вложений и состояний обработки.
- Разметка корпуса вместе с Codex, локальное обучение TF-IDF и MiniLM, сохранение версий и истории прогонов.
- Конструктор фильтров, словарь лейблов, раздельные оценки текста и OCR.
- Отправитель MAX, проверка доставки, очередь, повторы, миграции и развёртывание.
02 / Реализация
Что отличает реализацию
Оригинал не переписывается. Текст поста и надписи на медиа классифицируются отдельно. Фильтр проверяет оценки модели, а назначает обычный лейбл из моего словаря. Один пост может уйти в несколько каналов. Сохранённые ID сообщений и история попыток позволяют разбирать ошибки отправки.
Скриншоты
Экраны, формы, ошибкиСкриншоты, схемы и исходные материалы сохранены на языке оригинала; подписи и описание переведены.
03 / Технологии
Что использовано
Доли по размеру прикладных файлов Git в закреплённой версии. Каждый файл отнесён к одной подсистеме по правилам scripts/generate-stack-share.mjs; тесты, ассеты, зависимости и generated-файлы исключены. Округление — до 0,1%. Это состав кода, а не уровень владения технологиями.
Python / Telethon
Сбор из пользовательской Telegram-папки MAX
FastAPI / Jinja / JavaScript
Рабочий интерфейс, защищённые API и обновление доски
PostgreSQL / SQLAlchemy / Alembic
Оригиналы, задания, версии фильтров, лейблы, OCR и доставки
TF-IDF / scikit-learn
Основная автоматическая классификация
MiniLM / PyTorch
Обучение локально и ручное сравнение на сервере
RapidOCR / ONNX Runtime
Чтение надписей на медиа отдельным worker
MAX Bot API / httpx
Загрузка вложений, отправка и сверка сообщений
04 / Решения
Как устроен проект
- Новые сообщения принимает collector в режиме new_only. Старый необработанный буфер не запускается автоматически.
- Отдельные процессы: web, collector, coordinator, TF-IDF, MiniLM, OCR и отправитель MAX. Очереди и результаты сохраняются в PostgreSQL.
- RapidOCR читает изображения и статические превью видео. Распознанный текст не дописывается в публикацию.
- Отсутствующая оценка остаётся неизвестной. Фильтры поддерживают категории, подкатегории, обязательные признаки, длину и вложенные И / ИЛИ / НЕ.
- Отправляется оригинальный пост с медиа и ссылкой «Источник». Отдельного блока ссылок из текста нет.
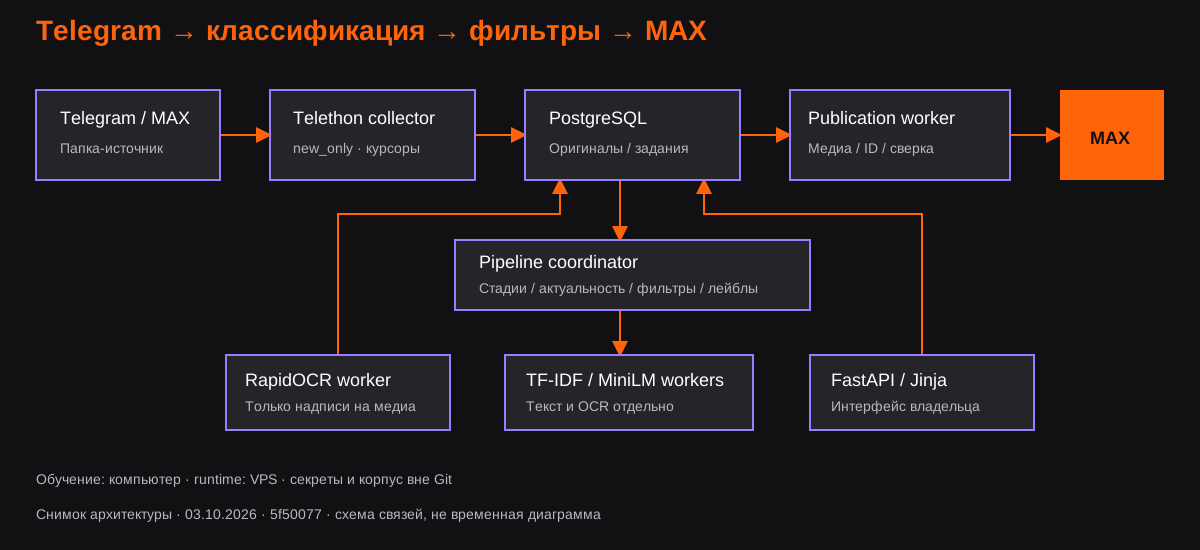
05 / Проверка
Сценарии демки
- Посмотреть публичные каналы MAX и пример перепубликованного поста.
- С доступом владельца открыть доску: Не готовы → Отсортирован → Отфильтрован → Маркировка → На публикацию.
- Открыть карточку и выбрать источник результата: текст поста или OCR. Сравнить сохранённые прогоны.
- Открыть фильтр: проверить модель, условия, лейбл и совпавшие основания в предпросмотре.
- В истории MAX проверить канал, статус доставки, сохранённую ссылку и ошибки.
Результаты проверок
- Девять каналов MAX подключены. Первая партия содержит 180 публикаций — по 20 на канал. Отправитель новых подходящих сообщений включён.
- В снимке истории есть последующие доставки. Число публикаций меняется по мере поступления сообщений.
Ограничения
- Метки корпуса поставлены Codex. Показатели моделей измеряют согласие с этой разметкой, а не независимую человеческую точность.
- Маршруты для новичков и юмора экспериментальные. Для новичков test: 57/65 совпадений; для OCR-юмора validation: 92/104. Согласованные пороги качества не пройдены.
- OCR не понимает картинку без текста, не слушает звук и не просматривает всё видео. Ошибки чтения требуют разбора.
- Медиа больше 100 МБ и недоступные части альбома блокируют автоматическую готовность. В интерфейсе есть остановленные карточки.
- Счётчики и время на скриншотах — снимок состояния, а не обещание производительности.
Технические заметки
Модули, API, схема данных, запуск и результаты проверок.
Документация →Материалы ↓