О проекте
Нужно было объединить сбор контента из VK, обработку изображений и текстов и операторскую проверку в одном наблюдаемом процессе. Каждая стадия должна оставлять проверяемый результат и поддерживать повтор без потери исходных данных.
WTG — VK parser и контентный pipeline. Система собирает публикации и связанные материалы через VK API и Playwright, сохраняет raw evidence, ставит OCR и классификацию в очередь и выводит результат оператору для проверки, разметки и решения о публикации. Страница фиксирует интерфейс, архитектуру, code-map и измерения проекта.
Что отличает реализацию
Raw evidence хранится отдельно от производных данных. Очереди разделяют сбор, OCR, классификацию и редакционное решение; оператор видит источник и промежуточные результаты до публикации. Code-map связывает экран и API с модулем, таблицами и проверками, поэтому изменение можно проследить по всей цепочке.
Состав прикладного кода
Доли по размеру прикладных файлов Git в закреплённой версии. Каждый файл отнесён к одной подсистеме по правилам scripts/generate-stack-share.mjs; тесты, ассеты, зависимости и generated-файлы исключены. Округление — до 0,1%. Это состав кода, а не уровень владения технологиями.
- Архивный кейс не содержит работающей демо-ссылки; поведение фиксируют обезличенные экраны, схемы и агрегированные измерения.
- Статусы заданий и confidence не являются измерением точности OCR или моделей.
- Legacy noVNC и недоступные разделы не выдаются за работающие.
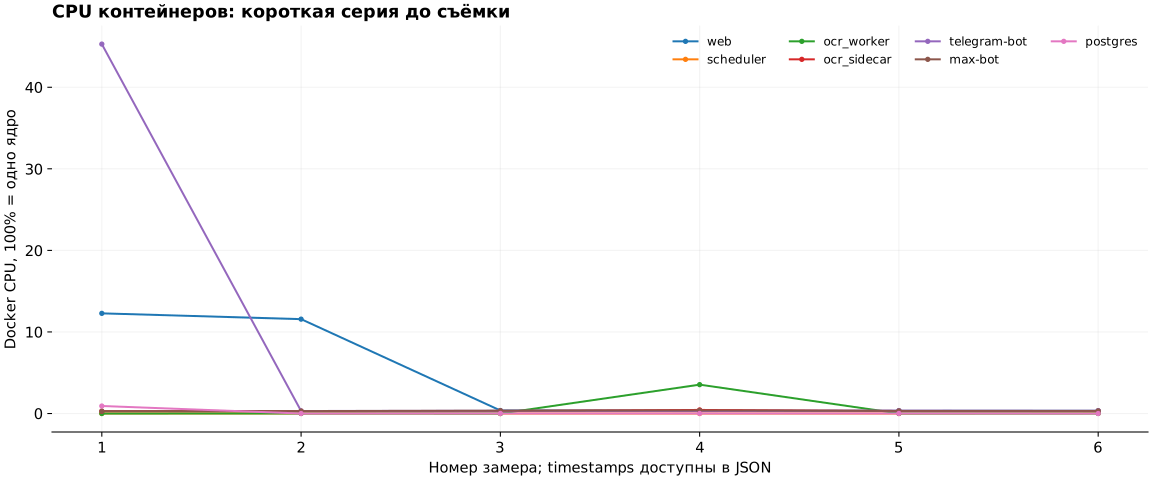
- Наблюдавшийся рост памяти web-процесса описан как факт замера; первопричина в коде не установлена.
Скриншоты, схемы и исходные материалы сохранены на языке оригинала; подписи и описание переведены.
Архитектура и схемы
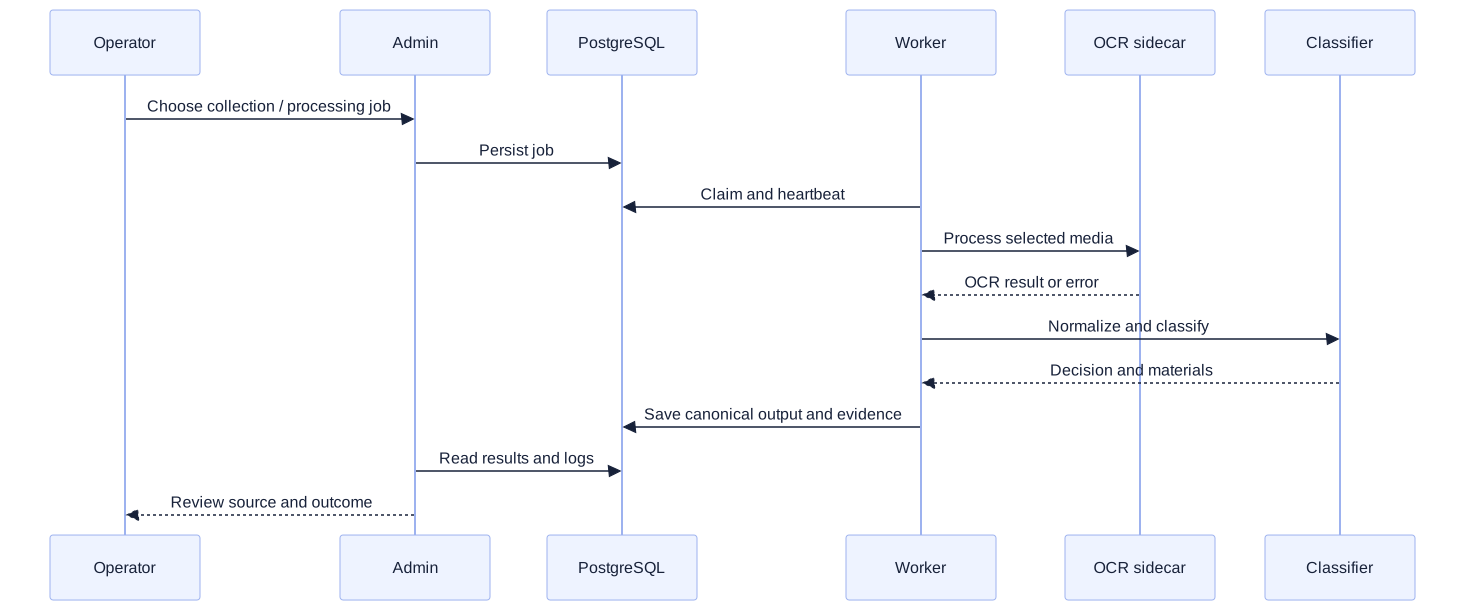
- Сбор и долгая обработка вынесены в задания с lease/heartbeat.
- OCR отделён от web и имеет самостоятельные очередь, статусы и попытки.
- Исходная публикация, промежуточные решения и итоговые материалы имеют разные роли.
- Публичный архив содержит обезличенные изображения, документацию и агрегированные измерения без пользовательских идентификаторов.



Code-map: файлы и связи
Карта привязана к версии 21841487f524. В таблице — экран или API, связанный модуль и данные.
| Функция | Экран / API | Модуль | Данные / проверка |
|---|---|---|---|
| Авторизация | accounts | services/auth.py, vk_user_token.py | auth_accounts, account_communities; browser/API состояния рассматриваются раздельно |
| Создание и исполнение заданий | schedules, processing | services/admin_control.py, cli/admin_worker.py | admin_jobs, admin_job_step_logs; claim, heartbeat, retry, stale cleanup |
| Планирование API | schedules, group-pool | services/api_posts_schedule.py | api_schedule_steps, api_group_pool_items; поколение расписания, очередь, cooldown |
| Сбор | groups, posts | services/crawler.py, vk_parsers.py | communities, posts, post_media; источник, повторное чтение, нормализация |
| Профиль и маркет | groups tabs, market | community_profile.py, community_market.py, community_services.py | профиль, товары, услуги; фильтры и привязка к группе |
| Быстрый отбор | group-pool | fast_screen_pool.py, fast_wall_probe.py | fast_screen_pool_states, fast_screen_pool_checks; lease, due rows, retention |
| Pipeline | pipeline | services/content_pipeline.py | content_pipeline_runs/posts/items; этапы и сохранённые результаты |
| OCR | processing, post details | ocr.py, ocr_jobs.py, cli/ocr_worker.py, cli/ocr_sidecar.py | ocr_jobs, post_media; completed/failed, attempts, timeout |
| Канонические материалы | results | publication_materials.py, publication-intelligence | publication_decisions/materials/media; связь решения с исходником и версия |
| Разметка и teacher | labels, processing | publication_teacher.py | teacher runs/results/applications; разметка, расхождения, применение |
| Логи | logs, file-logs | web/app.py, helpers file logs | admin_job_logs, step logs, files; событийные и файловые следы |
| Выдача | Telegram / MAX | отдельные bot repositories | canonical output + bot tables; downstream использует подготовленные данные |
Как работать с картой
- Перед изменением найти функцию и пройти связи до API, состояния и хранилища.
- Проверить входы, ошибки, повторные события и зависимые сценарии.
- После изменения обновить карту и затронутые схемы вместе с кодом.
- Выполнить связанные проверки и привязать новые материалы к версии исходников.
Сценарии и API
- Просмотрите обезличенные расписания, группы, pipeline и материалы.
- Сопоставьте экран со строкой code-map и схемой данных.
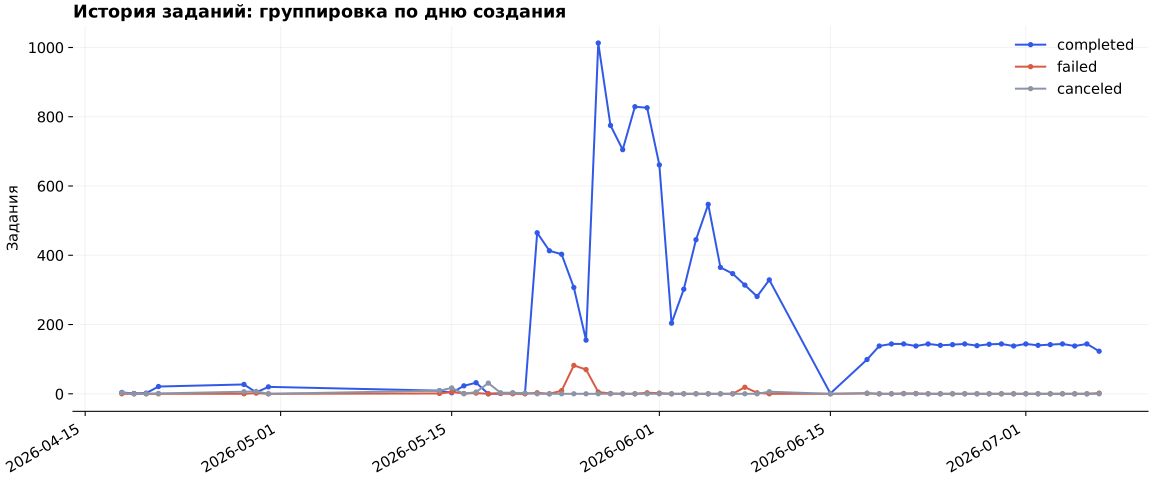
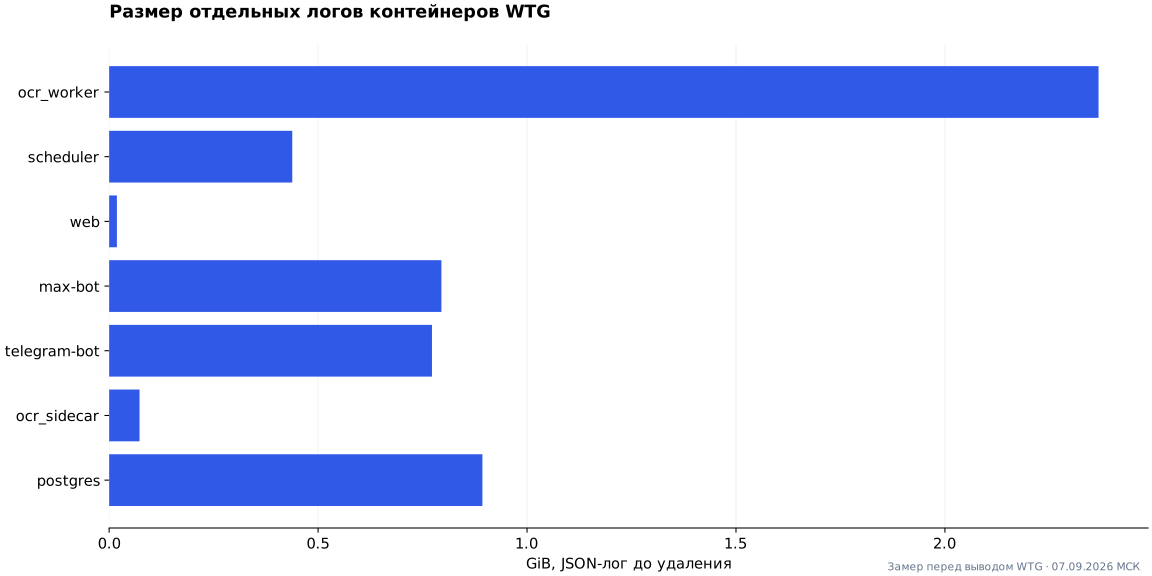
- Откройте агрегаты очередей и истории, прочитайте дату и ограничения замера.
Проверка опубликованной версии
CI: prod-deploy ↗ · 61c78116 · исторический запуск другой версии · 2026-06-16T11:57:17Z
CI: prod-deploy ↗ · 1299a357 · исторический запуск другой версии · 2026-06-16T11:45:01Z
- Обезличивание 30 снимков проверено по индексам материалов и полноразмерным изображениям.
- Code-map сопоставлен с экранными маршрутами, API, модулями, таблицами и проверками версии 2184148.
- Агрегаты очередей, OCR, публикационных материалов и размеров таблиц сохранены без пользовательских записей.
Эти проверки относятся к указанной версии. Коммерческие показатели и качество моделей на независимой выборке здесь не измерялись.
Измерения
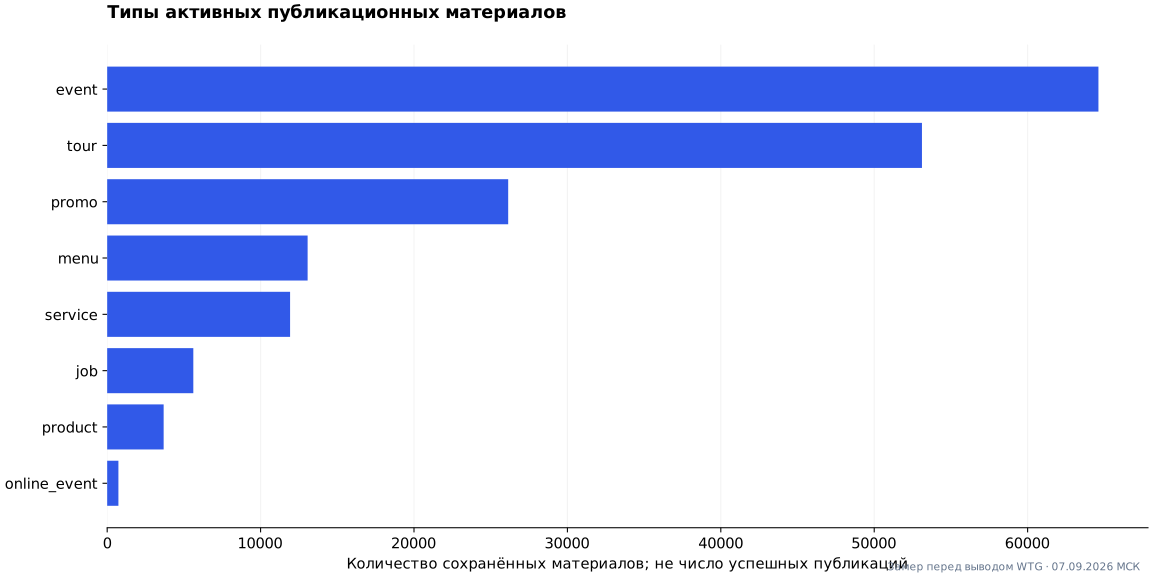
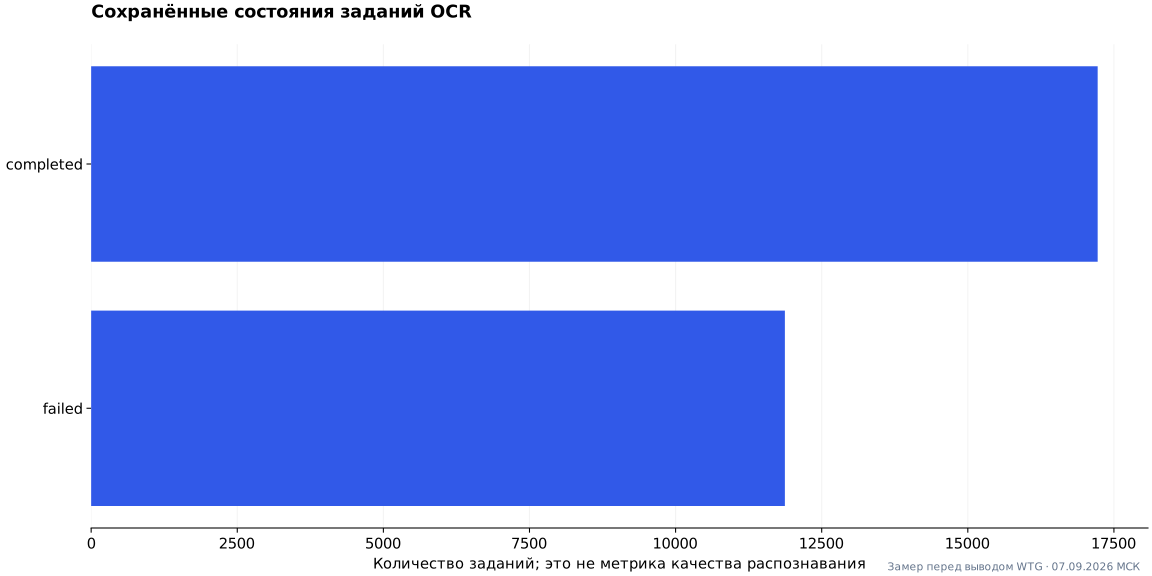
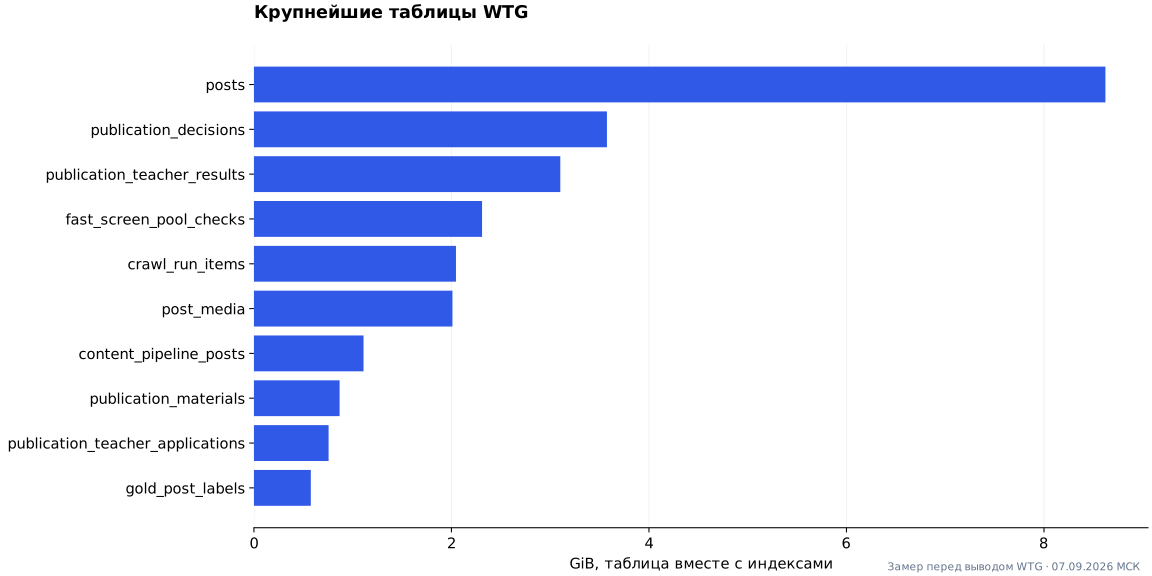
- Сохранено 30 содержательных кадров фактического интерфейса.
- Дата, сценарий и версия указаны у каждого кадра.
- Зафиксировано 527 718 публикаций и 29 092 OCR-задания; это разные сущности и не показатели качества.
Запуск и эксплуатация
Checkout на сервере и опубликованный аудитированный репозиторий имеют разные SHA. Источник каждого вида evidence указан отдельно; соответствие старого image содержимому checkout не утверждается.
Стек
| Python / FastAPI / Jinja | Операционная админка, JSON API и orchestration. |
|---|---|
| PostgreSQL / SQLAlchemy / Alembic | Публикации, задания, версии решений, материалы и миграции. |
| PaddleOCR | Отдельный OCR sidecar и worker. |
| Docker / Nginx / systemd | Прежнее размещение семи служб и фоновые задания. |
Материалы и исходники
Разработка и накопление материалов: июнь–июль 2026. Архивный кейс подготовлен 8 сентября 2026.
Архив материалов на языке оригинала.